


Geleneksel çok modlu (multimodal) yapay zeka modelleri, görüntü ve ses verilerini işlemek için yıllardır ayrı kodlayıcılara (encoder) ihtiyaç duyuyordu. Bu parçalı yapı, verinin model içinde dolaşırken gecikmesine ve sınırlı bellek kaynaklarının verimsiz kullanılmasına neden oluyordu. Google DeepMind’ın yeni duyurduğu Gemma 4 12B, bu teknik darboğazı aşmak için birleşik ve kodlayıcısız (encoder-free) bir mimariyle sahneye çıktı. Artık görsel ve işitsel veriler, harici işlem basamaklarına uğramadan doğrudan ana dil modeli omurgasına akıyor.
Kodlayıcısız Mimari: Gecikmeyi Bitiren Tasarım
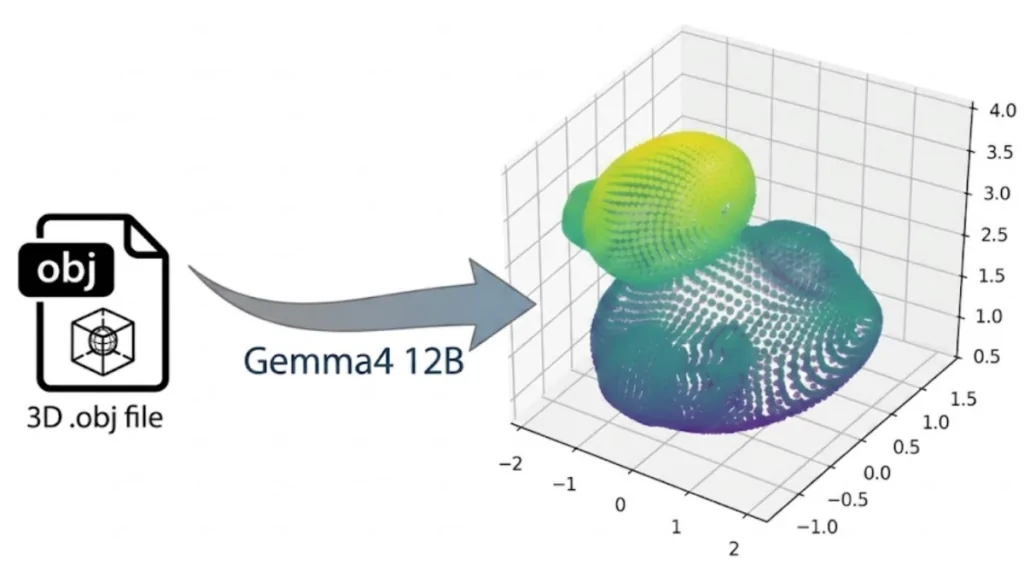
Mimarideki en çarpıcı yenilik, geleneksel ağır vizyon katmanları yerine sadece 35 milyon parametreli hafif bir gömme (embedding) modülünün kullanılmasıdır. Görüntüler 48×48 piksellik ham yamalar halinde sisteme beslenirken, ses tarafında da 40 ms’lik çerçeveler doğrudan metin belirteçleriyle (tokens) aynı boyuta yansıtılıyor. Bu sadeleştirme sayesinde, vision ve audio verileri LLM içinde tek bir ağırlık kümesi üzerinden işleniyor.
Bu yaklaşımın mühendislik açısından sağladığı avantajlar şunlardır:
- Düşük Gecikme: Çok aşamalı işleme süreçleri ortadan kalktığı için multimodal veri akış hızı artıyor.
- Birleşik İnce Ayar (Fine-tuning): Artık görsel veya işitsel bileşenleri ayrı ayrı eğitmek gerekmiyor; LoRA gibi yöntemlerle tüm sistem tek bir geçişte optimize edilebiliyor.
- Tutarlı Muhakeme: Verilerin aynı model içinde işlenmesi, modaliteler arası mantık tutarlılığını güçlendiriyor.
16GB VRAM ile Masaüstünde Ajan Deneyimi
Sahada çalışan mühendisler ve yerel sistem geliştirenler için modelin 16GB VRAM veya birleşik belleğe sahip standart bir dizüstü bilgisayarda çalışabilmesi kritik bir eşiktir. Gemma 4 12B, bu donanım sınırları içerisinde kalarak 26B Mixture-of-Experts (MoE) modellerinin performansına yakın sonuçlar üretebiliyor.
Cihaz bazında performans verileri şu şekilde özetlenebilir:
| Parametre | Linux (AMD Radeon™ AI PRO R9700) | macOS (MacBook Pro M4) |
|---|---|---|
| Prefill Hızı | 662.32 tokens/sn | 243.55 tokens/sn |
| Decode Hızı | 66.26 tokens/sn | 29.56 tokens/sn |
| Model Boyutu | 6235 MB | 6235 MB |
| Bellek Kullanımı | 8064.2 MB | 7763 MB |
Görsel ve İşitsel Analizde Yeni Standartlar
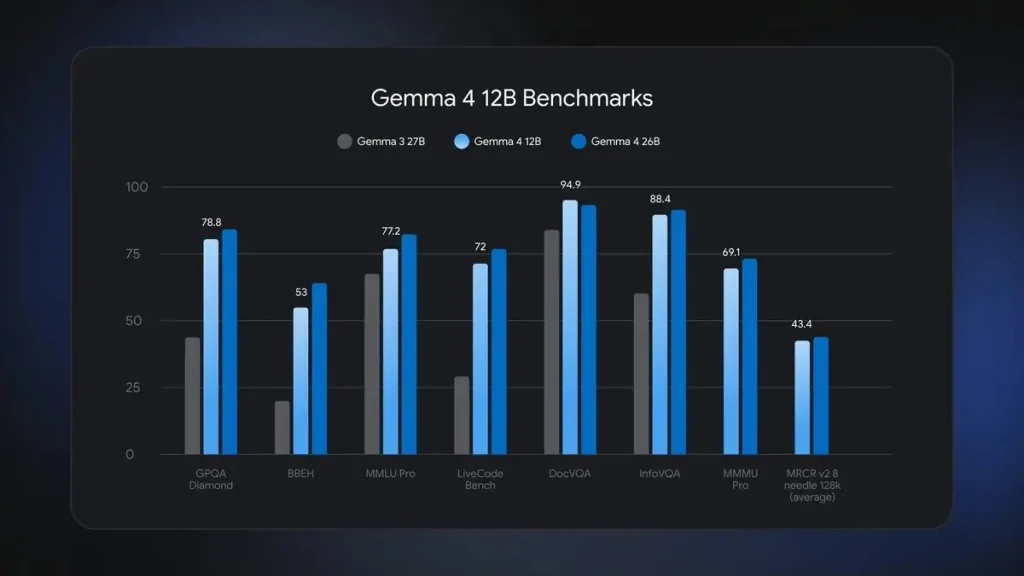
Modelin yetenek seti sadece metin üretimiyle sınırlı değil; yerel ortamda karmaşık agentic iş akışlarını yönetebiliyor. Özellikle Gemma Skills Repository aracılığıyla sunulan hazır yetenek kütüphanesi, mühendislerin kendi otomasyon araçlarını geliştirmesini kolaylaştırıyor.
Uygulama alanlarından öne çıkanlar şunlardır:
- Sesli Düzenleme: Ses dosyalarını yerel olarak yazıya dökme, formatlama ve çevirme işlemlerini yapabiliyor.
- Otonom Veri İşleme: Ham veri setlerinden otomatik olarak grafikler oluşturabiliyor ve Python kodlarını tek adımda düzeltebiliyor.
- Video Analizi: Saniyede 1 kare (FPS) hızında video akışlarını ses verisiyle birlikte analiz ederek içerik hakkında akıl yürütebiliyor.
Gemma 4 12B, Apache 2.0 lisansı altında yayınlanarak Hugging Face ve Kaggle üzerinden tüm geliştiricilerin erişimine açıldı. LiteRT-LM desteği ile yerel API sunucusu olarak çalıştırılabilmesi, mevcut mühendislik araçlarına entegrasyonu ciddi oranda hızlandırıyor.
Modelin tüm modaliteleri tek bir transformatör bloğunda birleştirmesi, gelecekte kontrol döngüsü (control loop) karmaşıklığını azaltan uç (edge) robotik sistemler için nasıl bir avantaj sağlayabilir?


